解Bug之路-隔离故障点后业务不恢复?-热点Key处理与亚稳态故障
核心反常点:跨机房机器让热点 Key 处理容量下降只是触发器,故障点隔离后队列积压和上游重试继续维持过载,系统进入亚稳态所以业务无法自动恢复。
解Bug之路-隔离故障点后业务不恢复?-热点Key处理与亚稳态故障
前言
《解Bug之路》作为笔者博客的镇站之宝系列,之前写的都是一些疑难杂症。但在和AI交流的过程中发现,一些对于笔者来说排查很直观的故障其实有不小的价值。这篇文章就是此种情况,虽然排查过程很直观,思路一直流畅没有卡点,但确有一定的通用性。所以笔者将其从素材库中捞出来写成一篇博客^_^。
故障现场
故障现场依旧是喜闻乐见的对系统A调用的超时,而且是大批量调用超时。在我们定位到故障点后,做了紧急的流量禁用等运维操作后,业务依旧不恢复,直到上游将流量降级故障才消除,上游重新打开流量后故障没有再次出现。
---
config:
  theme: base
  themeVariables:
    xyChart:
      plotColorPalette: "#0078D4"
---
xychart-beta
    title "业务超时报错量变化趋势"
    x-axis ["11:35", "11:37", "11:39", "11:41", "11:43", "11:45", "11:47", "11:49", "11:50", "12:00", "12:30"]
    y-axis "业务超时报错量" 0 --> 12000
    line [0, 0, 0, 9600, 9500, 9400, 7100, 7150, 6000, 0, 0]
flowchart LR
    A["12:00"] -->|"↓ 业务降级"| B["报错量归零"]
    B --> C["12:30"]
    C -->|"↓ 解除降级"| D["报错量依旧为零"]

    style A fill:#e8f3ff,stroke:#0078d4,color:#111
    style B fill:#e8f7ed,stroke:#22a06b,color:#111
    style C fill:#e8f3ff,stroke:#0078d4,color:#111
    style D fill:#e8f7ed,stroke:#22a06b,color:#111
由于故障影响比较大,于是笔者就被拉进去参与相关的问题调查。
报错系统A特点
在描述这个故障前,有必要让大家了解一下这个报错系统A的特点。系统A承载的业务特点在于它有很多热点Key,而且对于数据的一致性要求非常高,一旦不一致会导致后续的处理产生资损等严重问题。所以系统A并没有引入Redis等组件,而是对热点Key的修改全部由MySQL承载。为了解决MySQL孱弱的热点Key处理问题,系统A引入了批处理提交的方式,也就是缓存一部分数据以固定条数(最高20条)/固定时间间隔(最高20ms)的形式合并提交这部分数据,类似MySQL复制的组提交,不过是业务层面的。
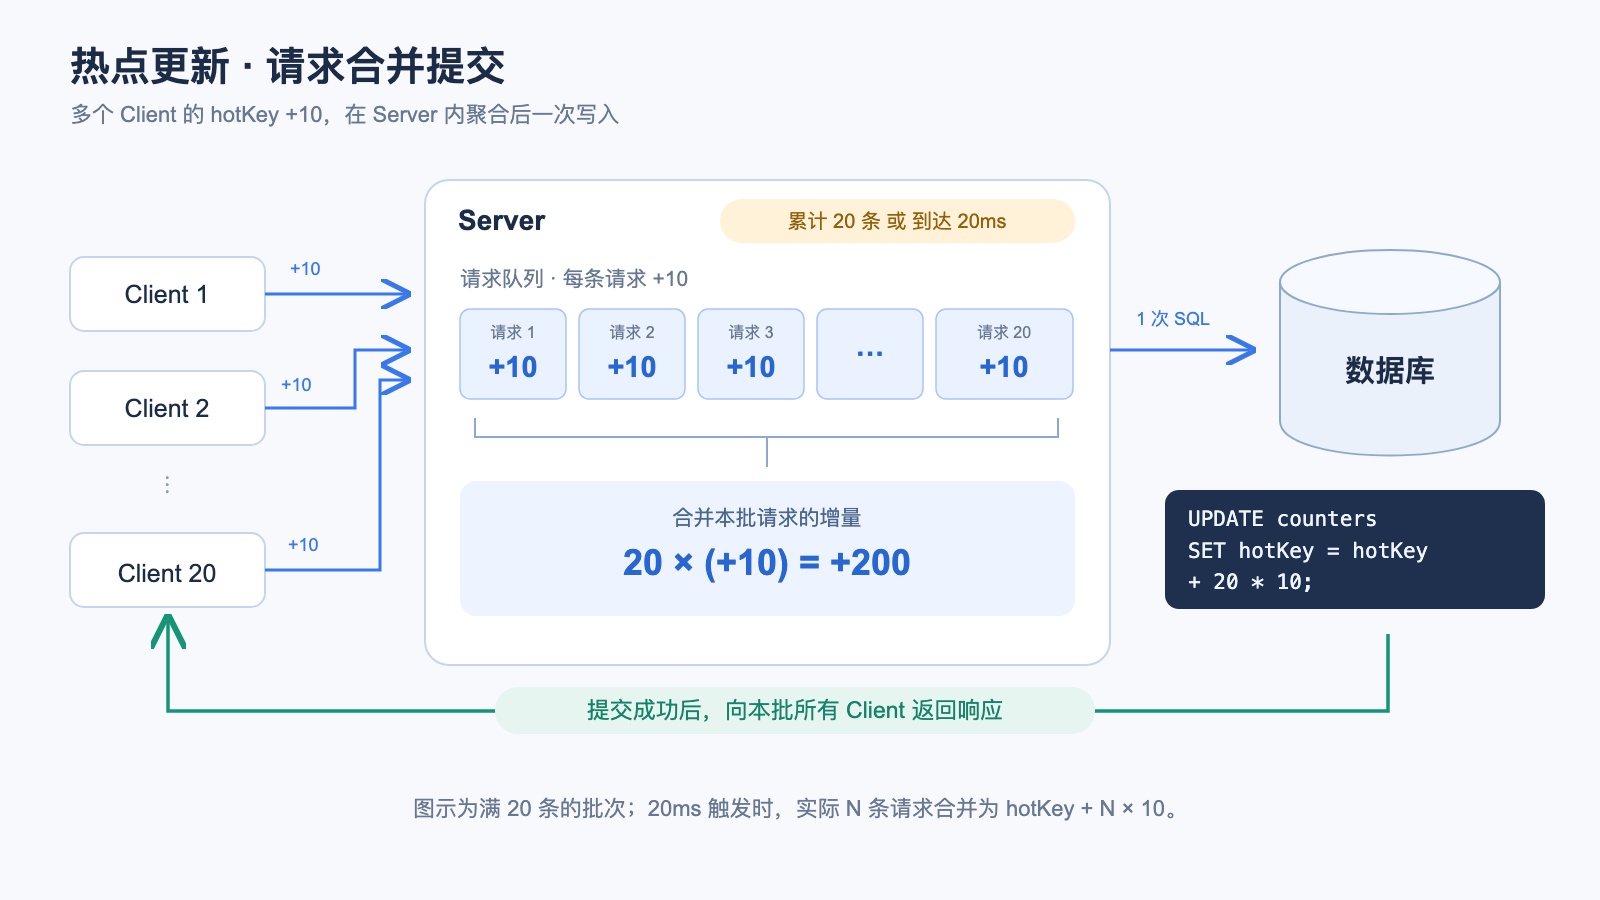
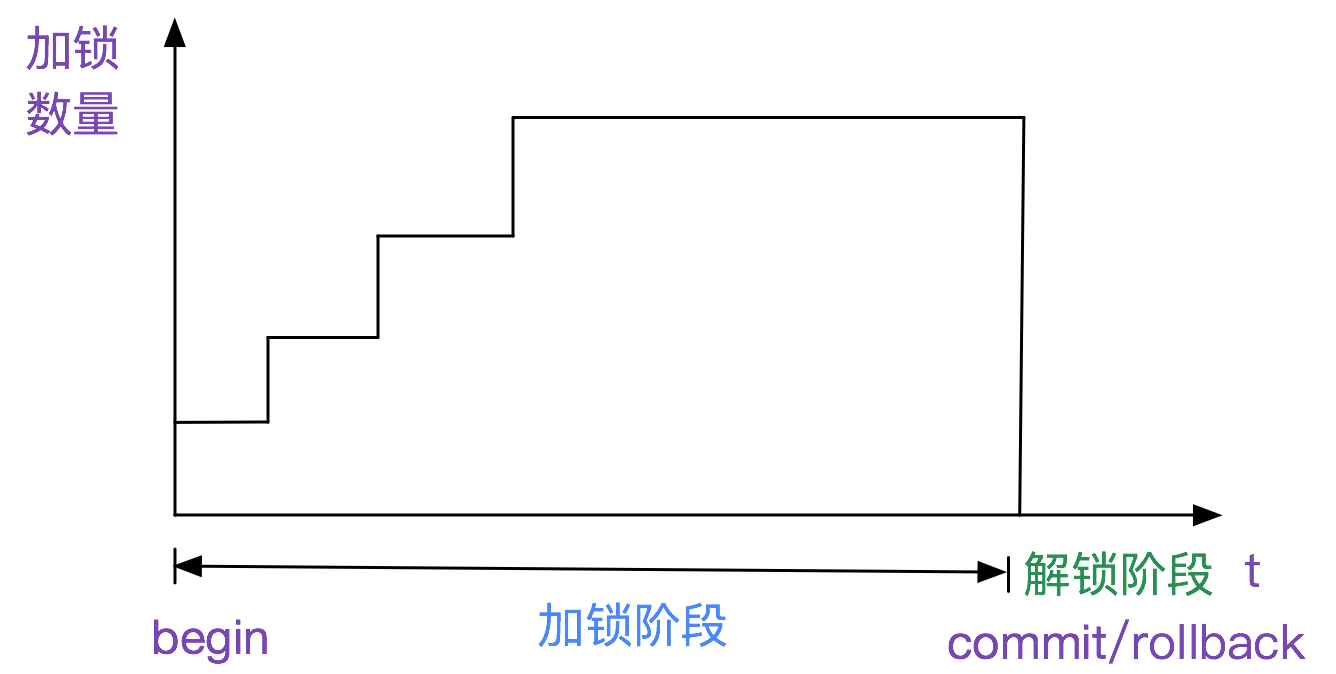
在采用了这种业务组提交机制后,我们对一个特定的hotKey采用的是单Server中的单线程处理的方案,当然不同的hotKey是可以分散到不同的机器上的。这样的原因是: 1.因为hotKey是热点,整个瓶颈都在事务开始的select for update上。由于MySQL两阶段锁(采用的是S2PL)的存在,所有的锁都只在commit或者rollback的时候释放,所以在MySQL层面不存在时间交叠,多线程无法突破MySQL锁等待导致的TPS上限。两阶段锁(S2PL)如下所示:
2.单Server这样能够更快地累积到20条这个限制,从而减少client等待。 3.单hotKey处理的性能瓶颈完全在数据库端,为了防止数据库本身的线程争抢导致性能降低,我们让业务Server以单线程轮询请求队列的方式不停的提交SQL,那么数据库端也就同时只有一个线程不间断的在更新hotKey。这样也就基本不存在可以利用的hotKey释放锁后的时间窗口,因为在高峰期是一直忙碌提交运转的。 让我们看一下SQL示意代码:
begin (set autocommit=0);
// 锁住account表中相关记录
select * from t_account where account_id=123 for update;
insert into t_trans values (xxx),(xxx),(xxx)
(batchInsert插入流水) 分块1
(BatchInsert插入流水) 分块2
……
内部一堆计算,同时计算出需要累加的value
……
// 增加计数
update t_account set count=count+value where account_id=123
commit;
为了简化示意,我们首先不考虑batchInsert到底运行了多少次。也就是计算下如果没有batchInsert的话,直观的看一下rtt的影响。在我们的模型中,其实我们的单次耗时为4次rtt+2条SQL耗时+1次commit耗时。如果按照rtt为0.5ms,commit和SQL耗时为0.3ms计算。则极限TPS为:
1000/(0.5 * 4 + 0.3*3)=345 TPS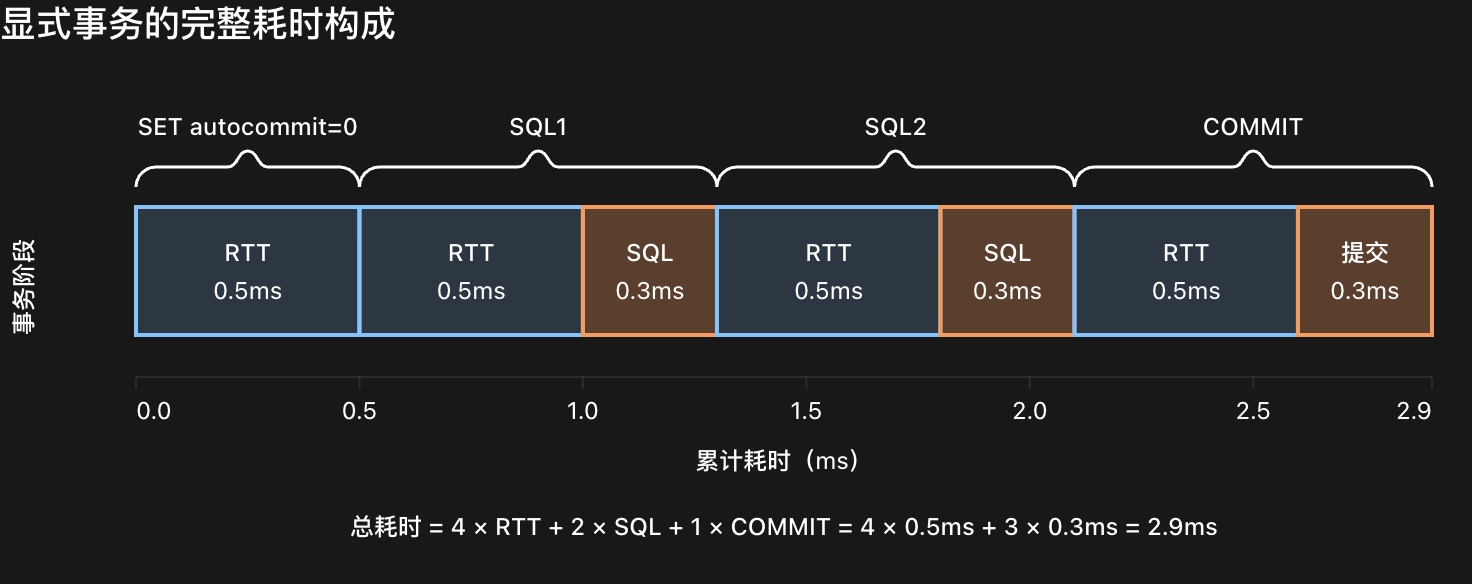
但这个是以rtt为0.5ms下的计算,一旦rtt为1.5ms,那么极限TPS则急速衰减为:
1000/(1.5*4+0.3*3)=144 TPS当然,实际batchInsert还是占了比较大的比重的。我们做过一个实测,在RTT为1.5ms的情况下,一次合并提交平均耗时为27ms左右,也就是37TPS。在RTT为0.5ms的情况下,平均耗时为16ms左右,也就是62TPS。注意,这里以及后续文章中的TPS都是合并提交的TPS,而非上游TPS
线上实测:
同机房RTT 0.5ms TPS=62
跨机房RTT 1.5ms TPS=37
性能剩余 37/62 = 59.6% 也就是会衰减为原先的60%
那么如何为hotKey选择应用机器呢
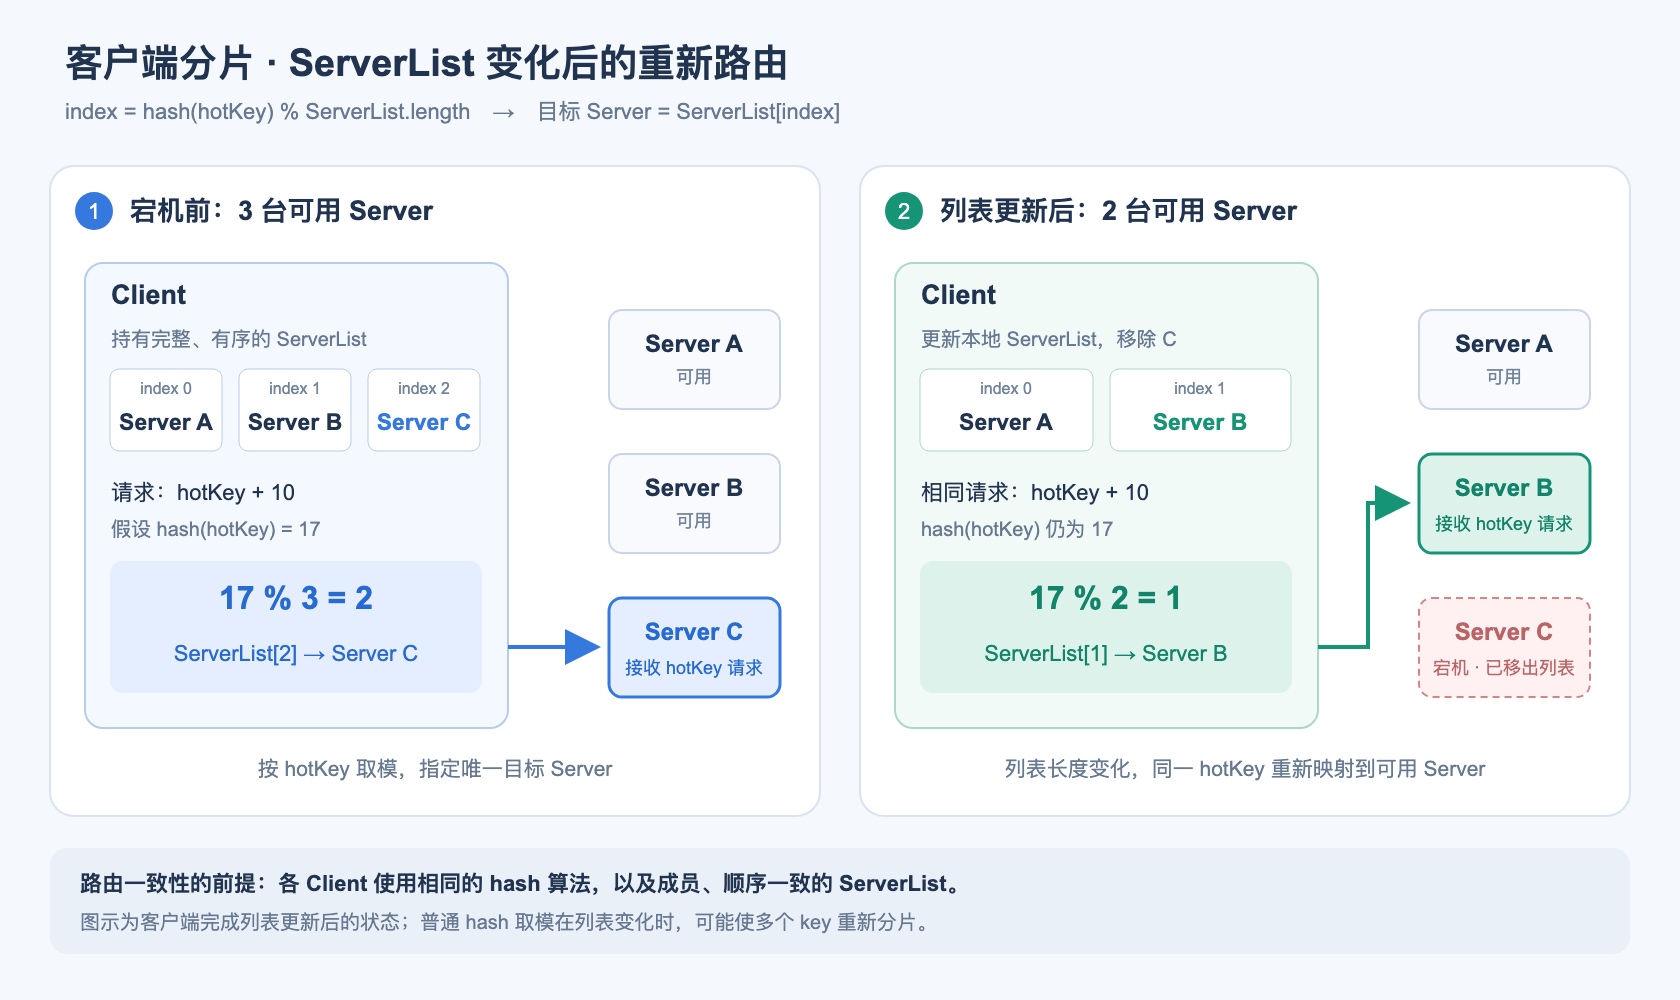
由上面的限制约束了我们对于单hotKey采用的是单Server的处理方案。但考虑到单Server处理hotKey有单点风险,我们必须考虑到单Server宕机的情况,但是引入分布式协调器又实在太重。于是我们借助了我们微服务框架注册发现机制的路由机制,在client端按照hotKey进行hash,然后sharding到一台我们可见的Server列表上。伪代码如下所示:
targetServer = serverList[hash(hotKey)%serverList.size]这样就算Server端对应的宕机了,client端也会很快感知到然后重新路由到一台新的Server,如下图所示:
开始分析原因
好了,有了上面的铺垫之后,我们就可以分析相关问题了。在大量超时时刻,我们发现client在调用Server端的时候,同一个hotKey分布在两台机器!这两台机器分属于机房B和机房C。这明显和我们设计的不符合,同时对应hotKey的主库在机房B。然后看了一下rtt,机房B内应用和主库的rtt在0.5ms左右,机房C内应用和主库的rtt在1.5ms,RTT暴增至原来的3倍!那么在这种情况下,根据监控打点,两台机器都在忙碌提交的情况下,一个单次合并提交耗时27ms,另一个单次合并提交耗时16ms。两者如果堆叠满了MySQL的hotKey锁时间窗口。那么平均处理耗时为(27+16)/2=21.5ms也就是整个系统的处理TPS为46TPS,衰减为正常情况下的46/62=74%。如下图所示:
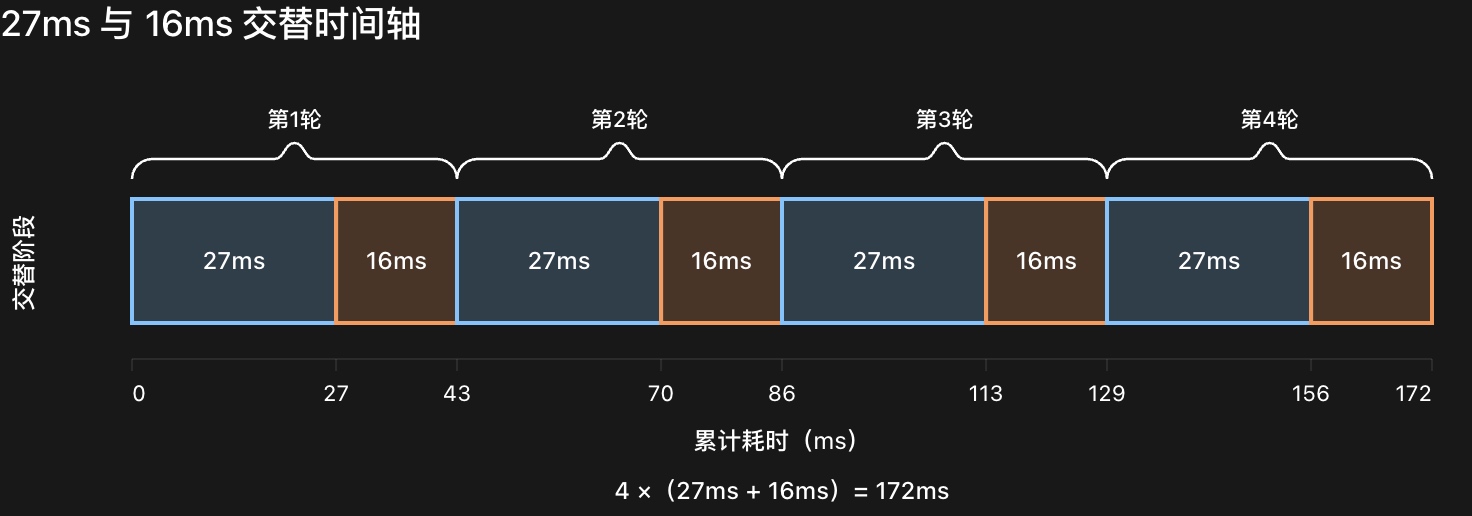
注:为简化计算,这里假设两台机器交替获得热点锁,各占一半处理批次。
为什么会出现两台机器同时处理hotKey的情况
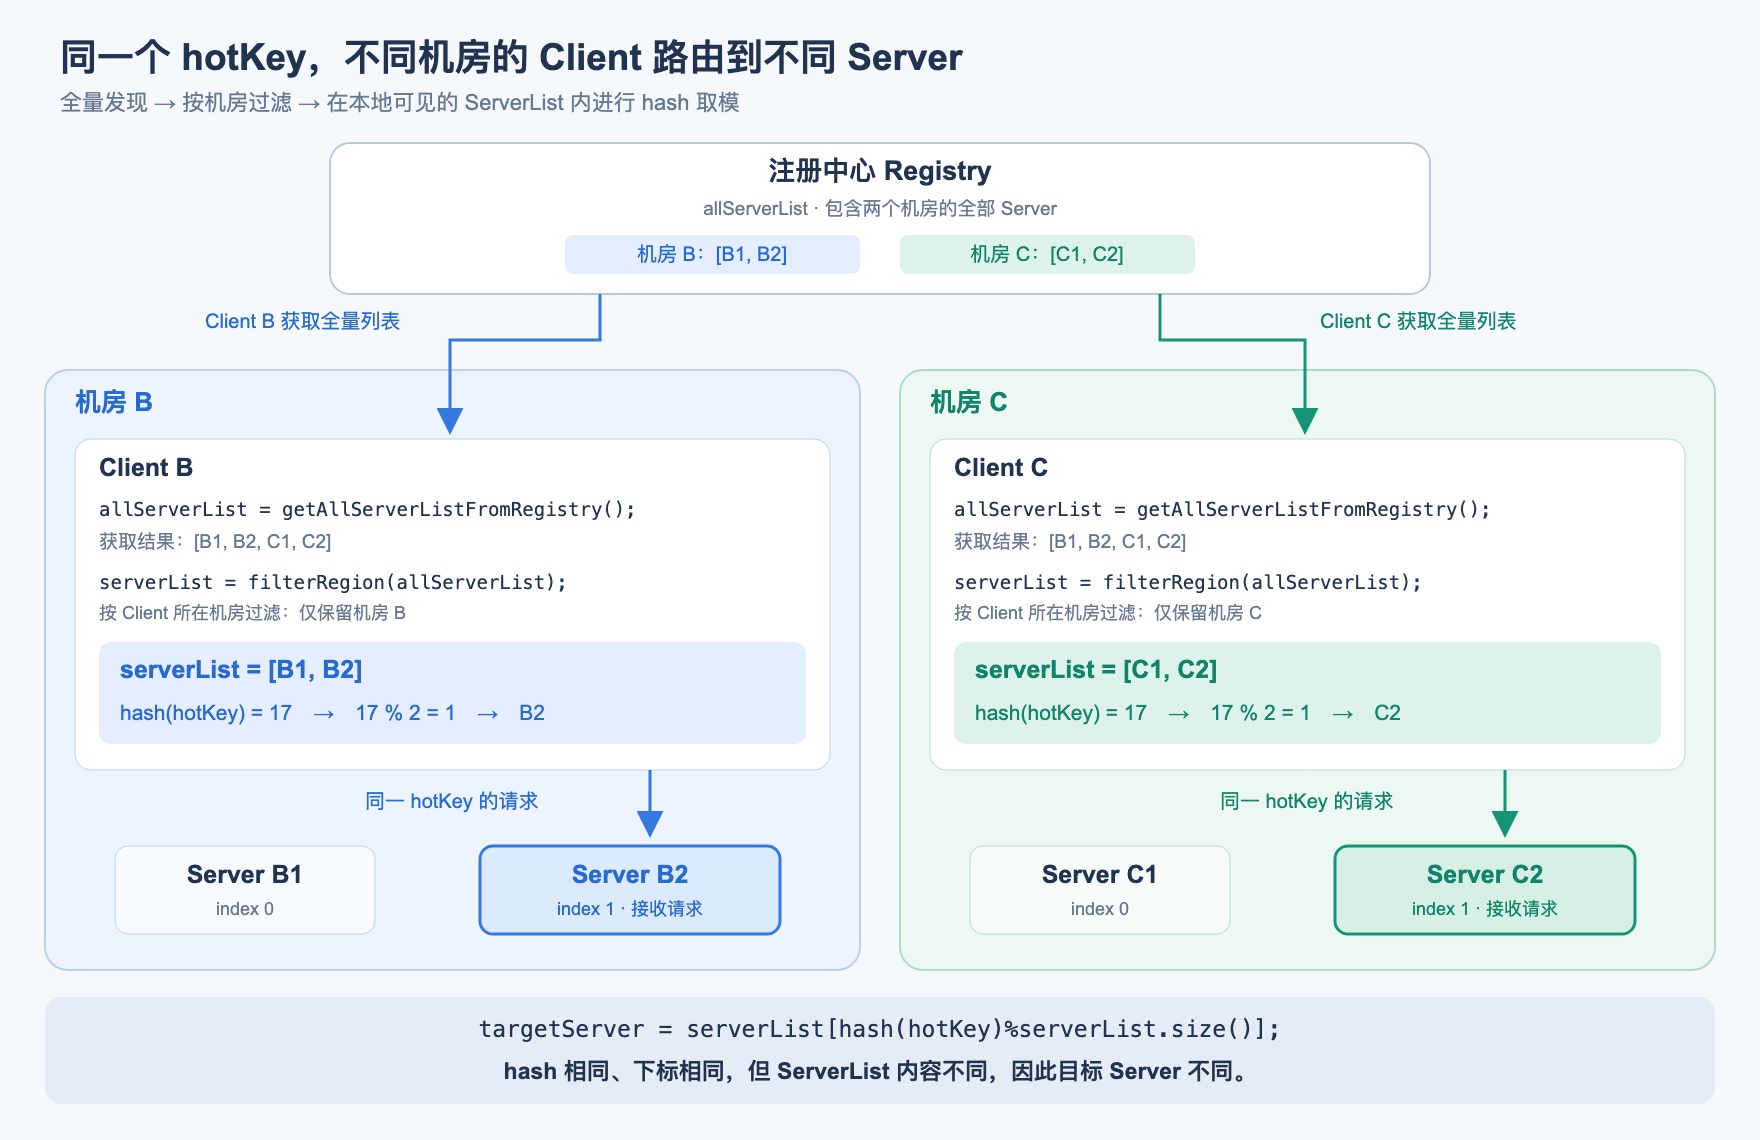
按照系统A的设计,client的路由机制是对serverList[hash(hotKey)%serverList.size()]。除非在机器serverList变动的情况下,不同的client由于一致性同步原因看到不同的serverList(在这里serverList是按照ip排序的,所以不存在乱序导致不同机器的可能)。但当时是在高峰期,机器列表应该不会变动。再翻翻之前的日志,好像前几天也是有两台机器在处理hotKey,同样的分布于不同的机房。那笔者不得不考虑,在某种情况下,client端看到的视角是不一样的。要说不一样的点,首先肯定是考虑的机房。于是笔者观察了RPC框架源代码,过程如下所示:
发现ServerList的过程:
1.allServerList = getAllServerListFromRegistry();
2.serverList = filterRegion(allServerList)
Client端路由的过程:
targetServer = serverList[hash(hotKey)%serverList.size()];
这样的话,很明显的由于不同机房的client看到的serverList不一样,自然产生了两台处理hotKey的效果,如下图所示:
这一点给笔者的教训是:
局部唯一,不等于全局唯一;确定性的算法,也无法消除输入视图的差异。甚至稳态下的全局唯一,也不代表动态过程中的全局唯一。由于信息无法瞬时传播,系统视图的波动会让多个观察者短暂地看到各不相同的状态。这一点,在修改配置、上线代码等变更过程中也需要牢记。为什么会出现超时
很自然的,这是一个生产队列模型,当偏离设计的第二台跨机房的机器出现后。根据我们前文的信息和计算,和主库同机房的单次合并提交耗时16ms, 和主库不同机房的单次合并提交耗时27ms,两者由于业务原因在开启事务后立刻锁住了同一个hotKey导致基本不存在时间交叠的空间(除了set autocommit和commit后的那仅有的RTT)。所以整个集群对于合并提交的TPS立刻被拉低为正常情况下的74%。这样势必出现队列累积,如下图所示:
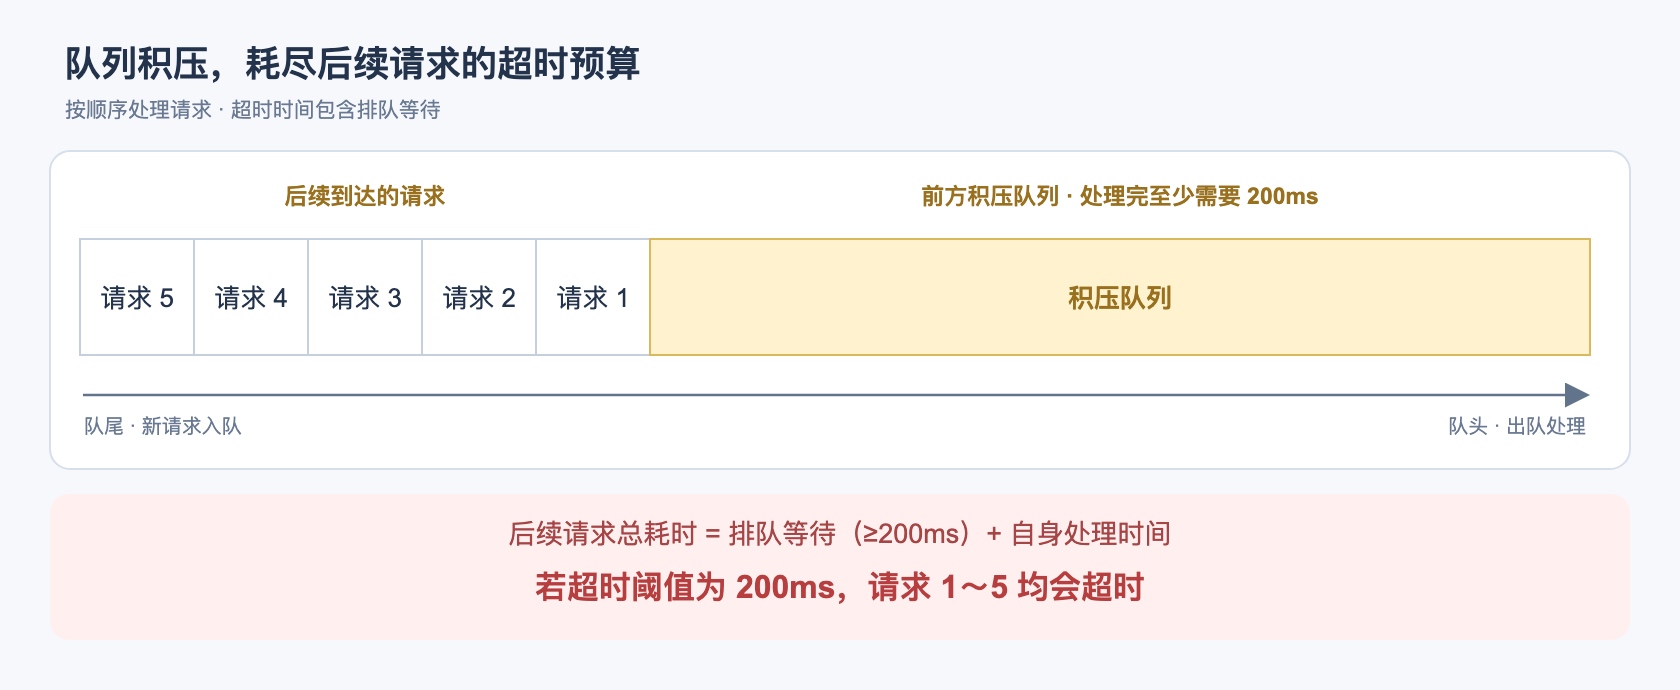
后续的请求在等待积压队列的处理,一旦:
(积压队列的处理时间+本身处理时间)>=client超时时间 势必所有的后续请求都超时。如下图所示,图中以超时时间 200ms 为例:
为什么会出现和主库不同机房的应用机器
这个核心在于当前运维层面并没有对应用的扩容做约束,导致在十几天前扩容应用的时候不小心在机房C多扩容了几台机器,从而酿成了这个问题。后续已经做了相关的巡检和运维层面的强约束。
为什么过了十几天后才开始触发问题
因为月初由于业务的原因会有一个流量高峰,大概高峰期比平时多20%流量,这个流量叠加后处于(拉低后的处理系统TPS,正常情况下的系统处理TPS)之间,造成了队列积压。
为什么紧急隔离之后不恢复
到之前为止,其实都是很正常的问题排查,没什么能够迟滞笔者思路的地方。但后面的情况就需要笔者思索一下了,当时我们发现有两台机器之后其实做了紧急的隔离操作将机房C的机器下线,但故障依旧不恢复。最后是通过降级生产端对hotKey的请求才让故障得以消除。事后,笔者思索了一下,大概是下面三个原因:
机房C的Server机器下线后,会被自动路由到另一台机房C的Server机器
当时采取的紧急操作是将有问题的Server机器紧急摘除流量,但这样也会导致serverList变化,于是机房C的上游client依旧会挑选另一台机器,这个防单点的选择机制在故障时候反而对我们应急处理造成了阻碍。当我们发现这一点之后,将整个机房C误扩容的Server机器全部给摘除了流量。
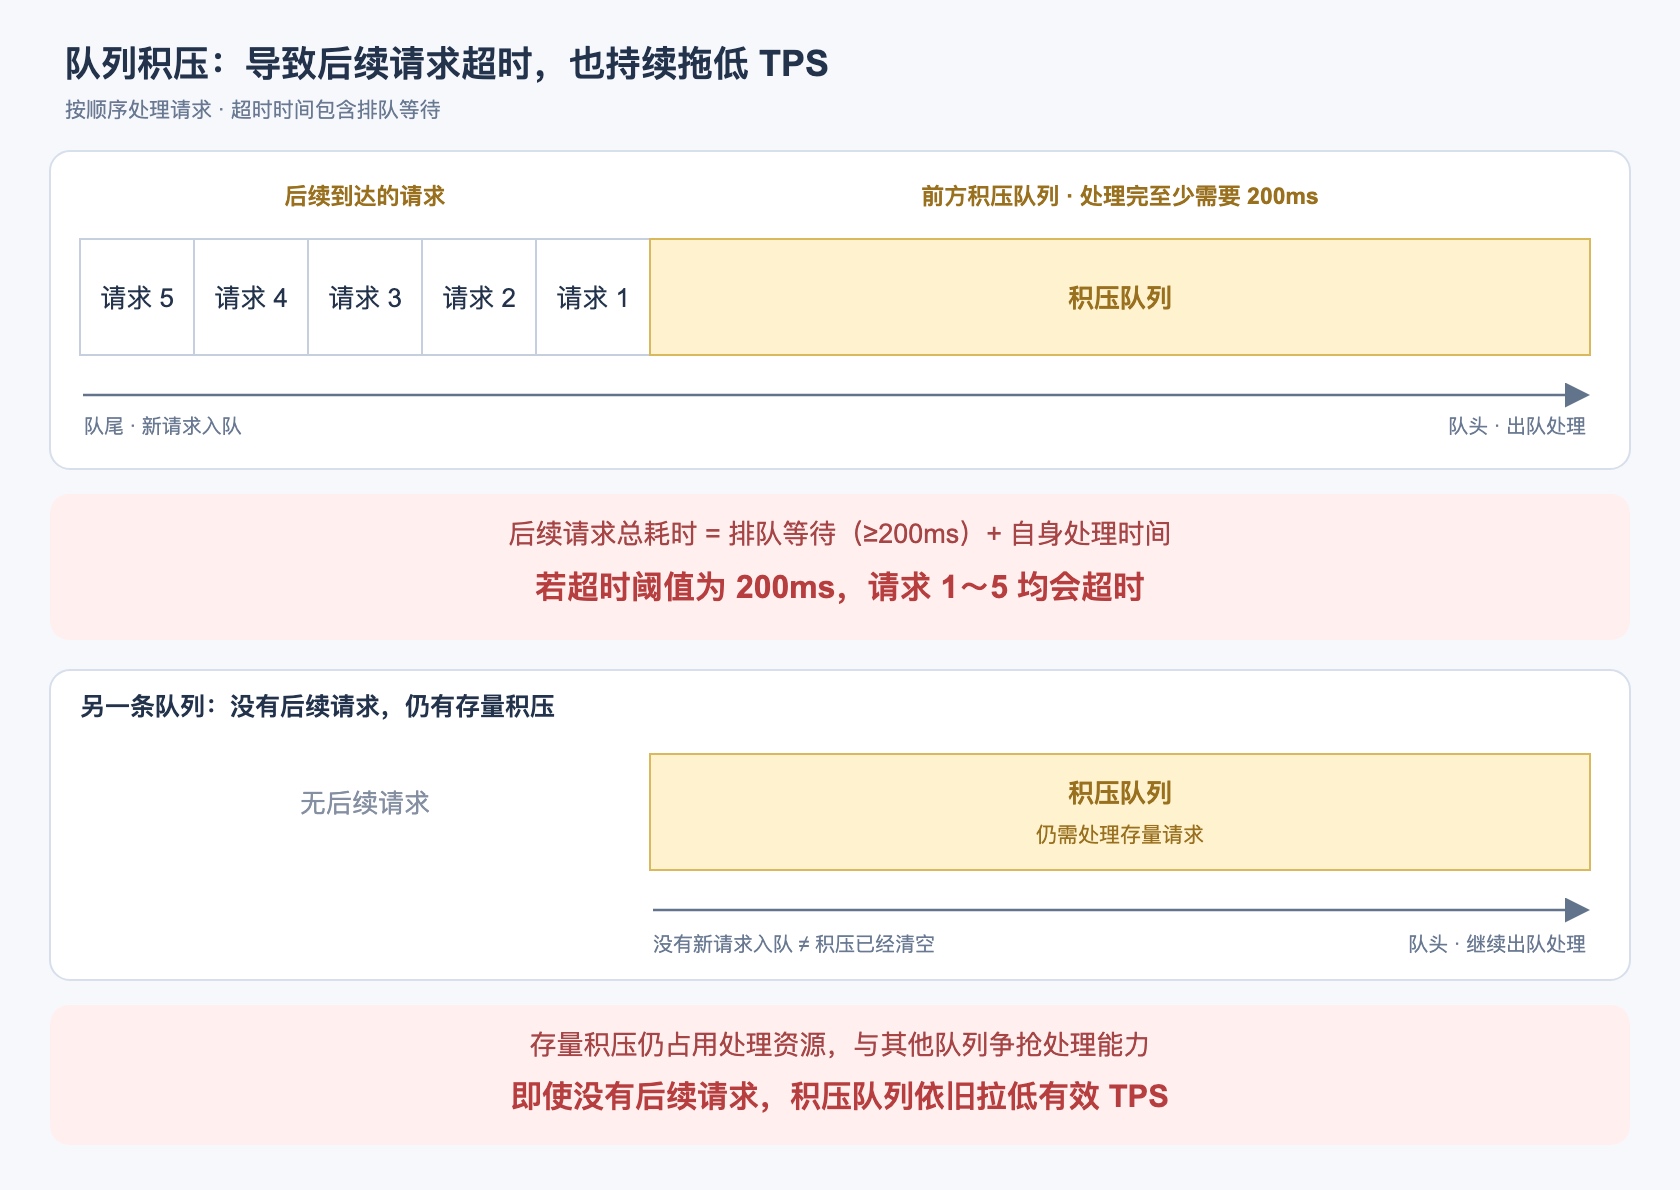
摘除流量之后,队列中依旧有积压的数据拉低整体容量
在我们将所有机房C的Server机器给禁用后,由于Server机器中还是有着大量的存量队列,虽然没有新的流量进入,但消费旧的在队列中积压的流量依旧需要不少时间,这一定程度上延缓了整体Server处理TPS的恢复,如下图所示。
和主库同机房的Server机器队列累积数据过长导致永远无法自动恢复
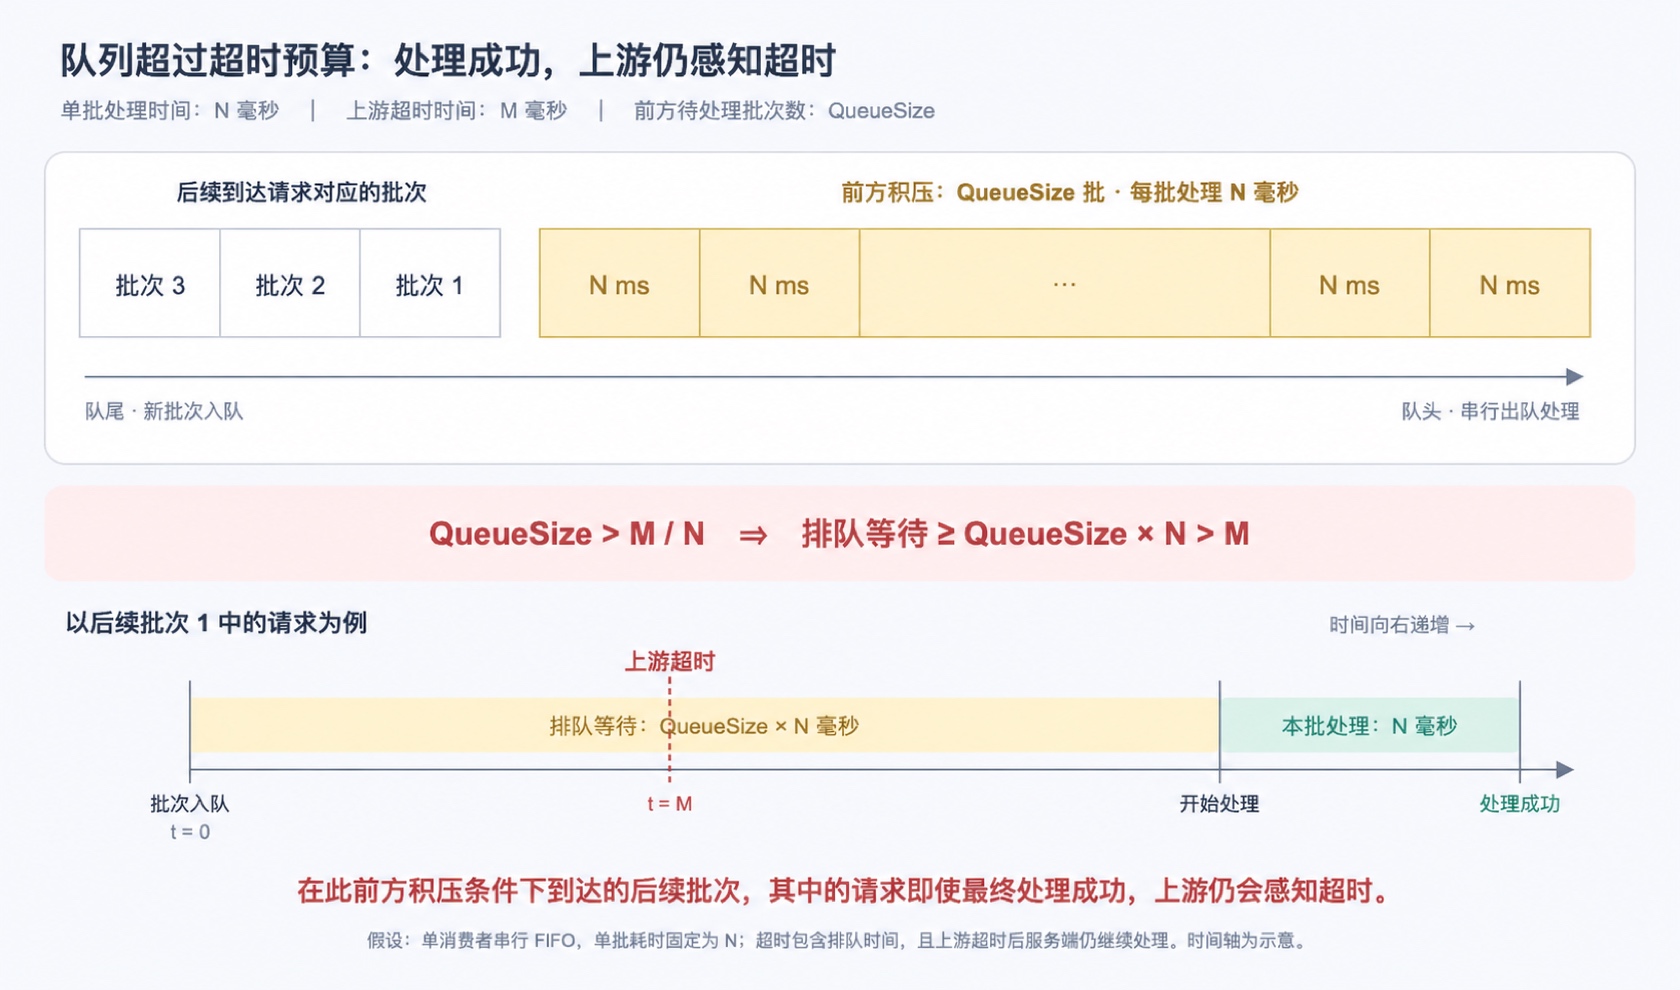
在解释这个问题之前,笔者需要先给出上游超时和队列长度之间的关系。如果我们队列的单次合并处理时间为N毫秒,上游的超时时间设置的是M毫秒,前方已有QueueSize(对于新请求这个QueueSize是队列当前长度)个待处理的批次。那么由于对于hotKey的处理是单线程操作,那么只要
N*QueueSize > M
注意:这个的N和QueueSize都是以单次合并处理请求计算的,而不是原始的用户请求
也就是在QueueSize> M/N之后,后续的所有请求都在等待前面队列的处理时间,进而全部超时。尽管请求实际上是处理成功了,但是client端依旧会认为是超时,如下图所示。
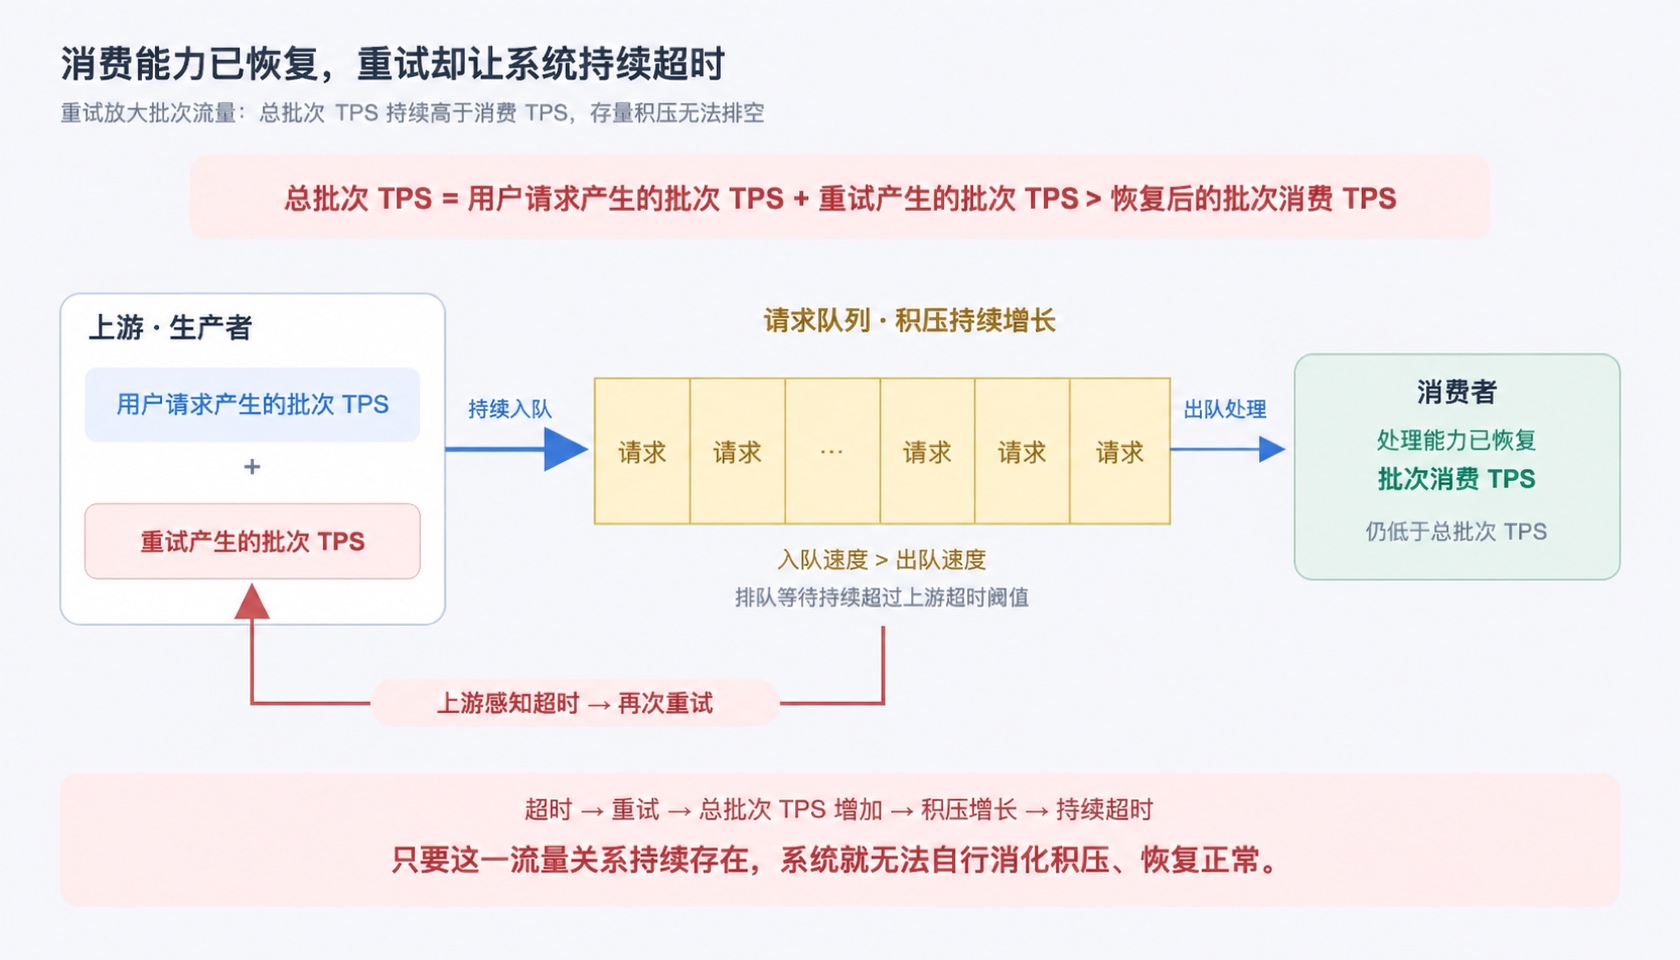
这时候,如果不做任何操作。只能等积压队列慢慢消化,也就是等消费TPS>生产TPS。在我们将所有C机房机器下线流量并且C机房积压队列由于没有新请求后而慢慢消化完毕后。我们的Server集群TPS依旧达到了正常的>业务实际TPS的水平,但依旧无法恢复。这里的核心原因在于上游的重试,在故障期间积累了大量的pending请求导致上游无限的进行重试。
生产批次TPS=(用户请求产生的批次TPS + 重试产生的批次TPS)>恢复后的批次消费TPS 导致一直无法恢复 如下图所示:
当然了,Server在设计的过程中确实是考虑到队列的容量保护功能的,只不过这个考虑是并没有考虑上游超时时间<队列处理时间的情况,这个队列长度设置的远大于临界QueueSize。虽然也导致了很多请求被队列拒绝,但依旧无法防止系统陷入这样的亚稳态。这里就给一下笔者的亚稳态定义吧:
当故障把系统推过临界点后,内部积累状态与外部反馈形成正反馈循环,使系统在原始故障消失后仍长期停留在异常状态;只有清除积累状态或切断反馈才能恢复。本文将这种状态称为亚稳态。不恢复是由于整个链路形成了亚稳态
我们可以看到,虽然后续Server处理hotKey的时候都是和主库同机房,消费TPS恢复正常,但由于队列长度超过了临界值导致整条链路在无人干预的情况下无法自动恢复。而且仅仅只有hotKey的处理有问题,其余请求都正常处理。整个链路达到了一个新的亚稳态的平衡。这是链路涌现出来的行为,不是靠处理故障点就能解决的。也就是:
初始容量故障只是触发器;故障点消失后,重试产生的额外负载继续维持过载状态,这才是系统无法自愈的持续机制。所以我们最后采取的生产端降级策略是非常正确的。
要是再出现这种情况,生产端无法降级时怎么办
这次故障是由于上游有紧急的降级能力,能够在源头降低用户流量,但是假设我们在上游无法降级的时候该如何做呢?如果发生类似的问题,笔者这边给出了两个措施:
1.直接重启正在处理队列的Server机器,这个请求队列直接清零,破除系统的亚稳态(当然前提是这些请求评估下来可丢,不会造成资金安全或者单损等问题)
2.抑制重试风暴,这就需要上游有临时改变重试时间间隔的能力
其它触发条件推演
在刚才的故障推演中,其实很容易得出,只要Server队列长度>(M/N)进而触发上游超时=>触发上游重试=>最后(用户请求产生的批次TPS + 重试产生的批次TPS)>恢复后的批次消费TPS。这个平衡点其实还是比较容易被打破的,例如:
1.上游突然来了一波尖刺流量=>打破队列临界点
2.Server对应的主库突然IO尖刺或者其他处理变慢=>打破队列临界点
3.Server端磁盘卡住导致请求累积=>打破队列临界点
为了避免这些条件的触发,事实上我们需要对队列长度做限制。也就是
队列最大长度QueueMaxSize必须<(M/N)*安全系数。这里的安全系数是避免耗时极度升高后的buffer。0<安全系数<1在对队列做了临界资源保护之后,就算出现上述以及其它情况下的抖动也能让整个链路不至于长时间陷入亚稳态,也就是能够让业务在故障点隔离后恢复过来。值得注意的是,重试时间间隔这一块其实也有讲究,如果都按照同样的时间间隔重试的话,很有可能导致大部分重试请求的到达时间也相同,那么由此造成的流量尖刺也极易造成风险。
为什么降级能够打破亚稳态
依旧采用我们刚才的模型:
队列增长速率= (用户请求产生的批次TPS + 重试产生的批次TPS)-恢复后的批次消费TPS
重试条件: (积压队列的处理时间+本身处理时间)>=client超时时间
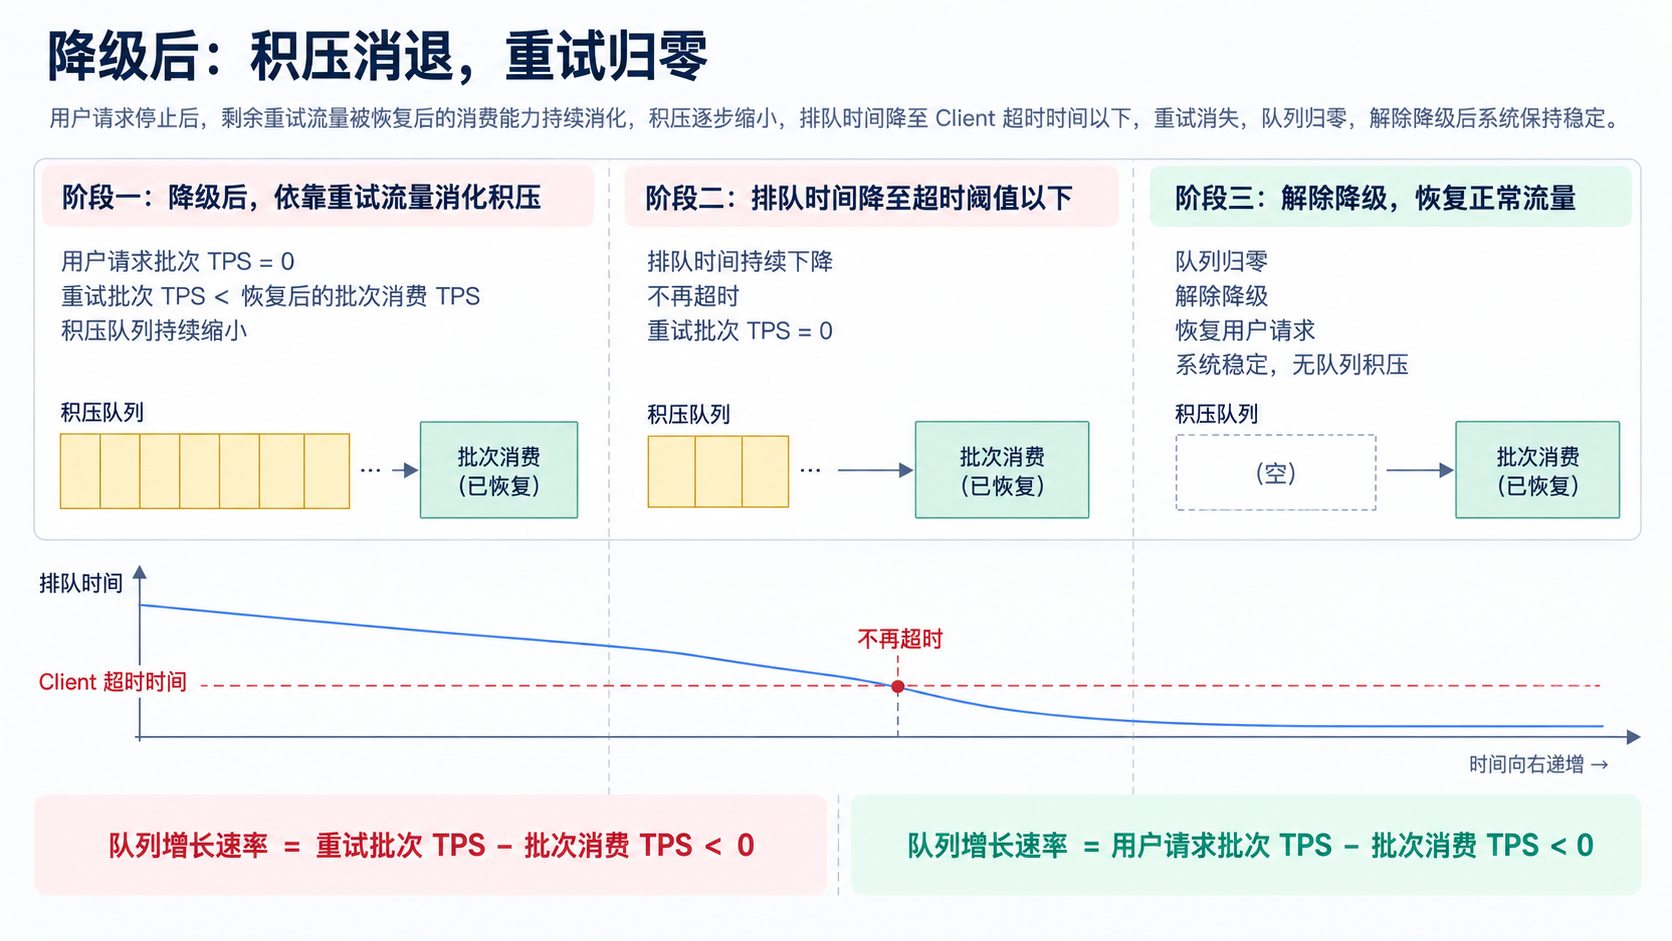
降级后:
队列增长速率 = 重试产生的批次 TPS − 恢复后的批次消费 TPS
由于重试 TPS 小于消费 TPS,队列增长速率小于 0,积压会持续缩小。
当:
积压队列处理时间(QueueSize × 单批次处理耗时)+ 当前批次处理时间 < Client 超时时间
请求便不再超时,重试 TPS 随之归零。此后,剩余积压继续被消费,队列最终归零。
解除降级后:
队列增长速率 = 用户请求产生的批次 TPS − 恢复后的批次消费 TPS
由于用户请求产生的批次 TPS 小于消费 TPS,系统能够稳定处理新增请求,不会再次产生队列积压。如下图所示:
当前模型的另一次故障重现
事实上,这种生产者消费者队列模型就极易出现类似的问题,在另一次故障中,出现了另一条类似的故障链条:
库存hotKey没有及时补充
    |->hotKey无法处理成功,留下pending记录。这时候pending记录生产速率已经远超消费速率了(毕竟批处理只考虑了处理正常偶发性pending的情况)
        |->pending记录累积过多,导致批处理在有效时间内无法完成处理。
            |->hotKey补充完毕后,但由于pending记录累积过多,批处理扫描数据库超时
                |->批处理产生的慢SQL在反复批处理之后累积巨量的慢SQL
                    |->数据库整体被拖垮,导致主从切换
                        |->新主库重复类似行为
同样的,由于队列累积,只不过这一次不是累积到Server的队列里,而是累积到数据库的记录中。又是类似的触发条件:超时时间<处理时间,反复累积拖垮主库导致整体不可用。这一次故障没有达到仅仅只有处理hotKey其它业务还好的亚稳态,而是由于主库挂了导致其它业务也不可用。由于有了上一次的经验,这次我们处理的时候直接做了下面的操作:
1.补充hotKey,封堵增量pending记录=>对应降低生产TPS
2.停掉pending批处理,优先响应正常请求=>对应直接将存量生产TPS给归零
3.修改存量批处理条件,给单次处理加上条数限制(之前只加了时间范围,单位时间pending过多就无法处理)。然后慢慢消化存量。
两次类似故障重新审视下故障模型
其实这两个故障总结下来就下面这三条:
1.队列变化速率 = 生产速率 - 消费速率,一旦队列变化速率大于0就会累积 2.一旦队列累积长度导致 队列处理时间 > 上游超时时间 → 后续请求持续超时 3.如果存量累积及其造成的反馈仍使生产速率 ≥ 消费速率→ 故障点消失,系统仍无法恢复,陷入亚稳态或直接不可用
第一次故障是消费速率骤降导致了队列累计长度超过临界点,消费速率骤降的原因是跨机房处理SQL。存量累积导致的重试拉高了生产速率,导致生产速率>=消费速率,陷入亚稳态。
第二次故障是生产速率骤增大于消费速率,生产速率骤增的原因是库存不够导致疯狂产生pending记录。存量累积后造成消费速率骤降,即使生产速率恢复了也导致系统不可用。
由上可以看出,队列的累积是魔鬼,一旦队列出现持续增加的累积就是系统开始走向不稳定的征兆。所以,我们需要对这种队列的累积作出有效的监控。但队列本身并不是仅仅以显式的形式存在的,数据库pending记录/内存中的队列/MessageQueue/MySQL的锁等待等等都可以作为等效的队列载体。
如何防范这种问题
事前防范
生产者消费者队列模型广泛的在我们的生产系统中应用。以往只关注了消费速率和生产速率的关系,队列的Size仅仅作为不拖垮Server端而配置为一个较大的数值。在这反复出现的相同模式的故障中,我们发现对队列或者等效形式都需要做一个严格的有界性保护。在队列过长的情况下,Server本身成功处理的队列中的请求反而会成为上游超时的毒药。为了整条链路的稳定性,需要满足:
队列最大长度QueueMaxSize < (M(上游超时时间)/N(单次处理超时时间)) * 安全系数 另外,为了防止上游无限重试,我们需要做下面的操作:
1.设定最大重试次数
2.逐渐拉长重试间隔,例如指数退避
3.重试间隔需要加上随机性,以避免同时全部重试导致的流量尖刺
事中
一旦在发现类似的生产者消费者模型导致的故障后,我们就可以采用下面的路径来紧急操作:
If 上游可以降级:
    直接降级来降增量
Else:
    无法降级后,则保增量降存量。
    也即通过清空队列或者停止存量扫描的方式。保证新的请求能够处理,然后再慢慢的处理存量。当然在清空队列前我们必须确定这个不会造成资金安全/单损等问题。
事后
我们需要按照相关的生产消费模型识别出整个链路中的等效模式,然后对资源做有界保护,阻止系统进入无法恢复的境地。
总结
生产者消费者模式是我们在系统构建中普遍采用的模式,对于队列的有界保护往往只限于不拖垮消费端,而在全链路的角度来看,超时时间的限制往往会对队列大小提出更加严格的要求。同时由于这种模式存在种种变种,例如不仅仅是显示的队列容量,数据库pending记录或者MessageQueue累积等等都是等效的形式。甚至全链路的整个容量模型都可以抽象为生产者消费者模型,我们必须仔细的对其中的队列及其等效形式做有界保护/可降级等措施,才能保证我们的整个链路在故障隔离后快速恢复。高可用不仅仅是为了防止故障,更是为了在出现故障后能够让整个链路具备承受和恢复故障的能力!